
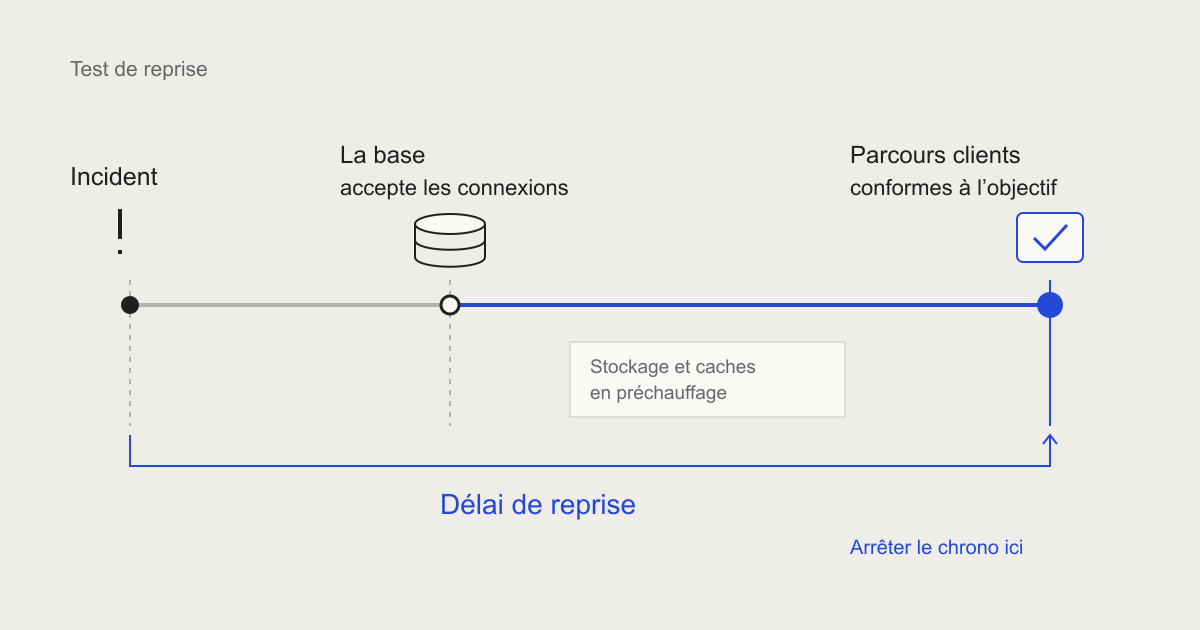
Un exercice de restauration peut être déclaré réussi alors que le paiement expire encore. Si le test s’arrête dès que la base accepte une connexion, personne n’a établi à quel moment les clients peuvent à nouveau utiliser le produit. Cet intervalle doit faire partie du plan de reprise.
Un article technique d’AWS du 14 octobre décrit des instances RDS pour PostgreSQL disponibles alors que des données de l’instantané se chargent encore à leur première lecture. Le plan de reprise doit tenir compte de l’expérience client pendant cet intervalle. Qu’entend exactement l’équipe par « service rétabli » ?
Choisir les opérations qui doivent reprendre
Commencez par une courte discussion entre les responsables du service et ceux de la relation client. Quelles opérations doivent reprendre en premier ? Une boutique peut afficher un catalogue en cache tout en restant incapable d’enregistrer une commande. Un outil d’entreprise peut rouvrir son tableau de bord sans pouvoir sauvegarder une validation. Choisissez quelques parcours complets, écritures comprises, plutôt qu’une liste de composants en bon état.
Donnez à chaque parcours une condition d’acceptation : résultat attendu, temps de réponse acceptable et niveau de trafic. Distinguez le RTO, l’objectif de délai de rétablissement du service, du RPO, la perte de données acceptable exprimée en durée. Un paiement rapide sur une base trop ancienne peut respecter le premier objectif et manquer le second. Chacun doit avoir un responsable capable d’en accepter les conséquences pour l’activité.
Partir de l’état que laisserait un incident
Pour l’exercice, restaurez une sauvegarde récente et représentative dans un environnement isolé. Protégez les données comme en production et désactivez les paiements réels, les messages et les tâches qui agissent sur des systèmes externes. Notez le point de reprise de la sauvegarde et l’heure de fin de chaque étape. Évitez de préparer discrètement une base déjà préchauffée la veille : vous supprimeriez une partie du travail que l’exercice doit mesurer.
Une minuscule base de test peut masquer le temps nécessaire pour déplacer les données et charger celles que l’application utilise. Prévoyez un volume et une répartition représentatifs, avec masquage ou données synthétiques si nécessaire. Consignez les écarts impossibles à reproduire, comme les quotas ou la capacité réseau. Le résultat vaut pour ces conditions ; ce n’est pas un délai de reprise universel.
Faire fonctionner l’application avant de déclarer la reprise
Reconnectez l’application selon la procédure documentée, puis exécutez les parcours retenus. Vérifiez les droits des comptes, les secrets, les pools de connexions et les traitements en arrière-plan réellement utilisés. Passez une commande de test, puis retrouvez-la. Enregistrez une validation et consultez sa trace d’audit. Un contrôle de santé de la base ne répond pas à ces questions.
Augmentez progressivement une charge contrôlée en observant les temps de réponse, les erreurs et la croissance des files d’attente. Un système restauré peut traiter une requête puis prendre du retard au retour des clients. Laissez tourner le chronomètre jusqu’à ce que la charge convenue soit supportée de manière stable. Si une partie du produit reste indisponible, indiquez-le clairement pour que le support puisse expliquer ce qui fonctionne et ce qui attend encore.
Examinez aussi les opérations autour du point de reprise. Un prestataire de paiement peut avoir accepté un paiement que la base restaurée ne connaît plus. Tout rejouer risque de produire un second effet externe. L’exercice doit préciser quels enregistrements rapprocher, comment empêcher les doublons et qui décide de la reprise du traitement.
Préchauffer d’abord les parcours importants
Quand les lectures à froid constituent le goulot d’étranglement, testez un préchauffage volontaire avant de rétablir le trafic normal. Commencez par les tables et les index utilisés dans les parcours prioritaires. Le module pg_prewarm de PostgreSQL peut charger les données dans les caches du système d’exploitation ou de la base. Sa documentation précise aussi que ces blocs peuvent être évincés : charger plus de données que le cache ne peut contenir ne les maintient pas toutes en mémoire.
Le préchauffage dépend donc de l’usage. Lire chaque table peut retarder les opérations prioritaires et consommer les entrées-sorties dont l’application a besoin. Comparez, dans les mêmes conditions, un préchauffage ciblé, un retour progressif du trafic et la procédure actuelle. Choisissez en fonction du délai jusqu’à un service utilisable, du coût des ressources et de la complexité d’exploitation. Le benchmark d’un fournisseur ne constitue pas votre engagement de reprise.
Transformer l’objectif manqué en décision budgétaire
Si le délai mesuré dépasse l’objectif de l’activité, repérez l’étape lente avant d’acheter une seconde région ou une base plus puissante. Trouver la bonne sauvegarde, obtenir les accès, restaurer le stockage, préchauffer les données et rapprocher les enregistrements appellent des réponses différentes. Si l’attente vient des accès, automatiser une approbation manuelle peut aider davantage qu’augmenter les capacités d’entrées-sorties.
Un petit produit peut accepter une interruption plus longue et conserver une procédure simple. Un service traitant des transactions urgentes peut avoir besoin d’un système de secours maintenu, d’une bascule répétée en exercice ou d’un mode dégradé limité. Ces choix entraînent un coût récurrent et multiplient les possibilités d’erreur d’exploitation. Mettez ce coût en regard des conséquences d’une interruption et de la capacité de l’équipe à maintenir la solution.
Laisser des résultats que la prochaine personne pourra utiliser
Le livrable utile est une procédure courte avec la sauvegarde testée, les hypothèses d’environnement, les accès nécessaires, les contrôles des parcours et les durées mesurées. Désignez la personne qui peut déclarer le service rétabli et celle qui informe les clients. Incluez le travail de rapprochement restant après le retour du service.
Recommencez après une évolution importante du volume de données, du stockage, des dépendances ou de la procédure de reprise. Conservez le résultat précédent pour voir si la reprise ralentit. La discussion suivante pourra porter sur un écart précis et une correction proposée, plutôt que sur une nouvelle assurance que les sauvegardes sont activées.