
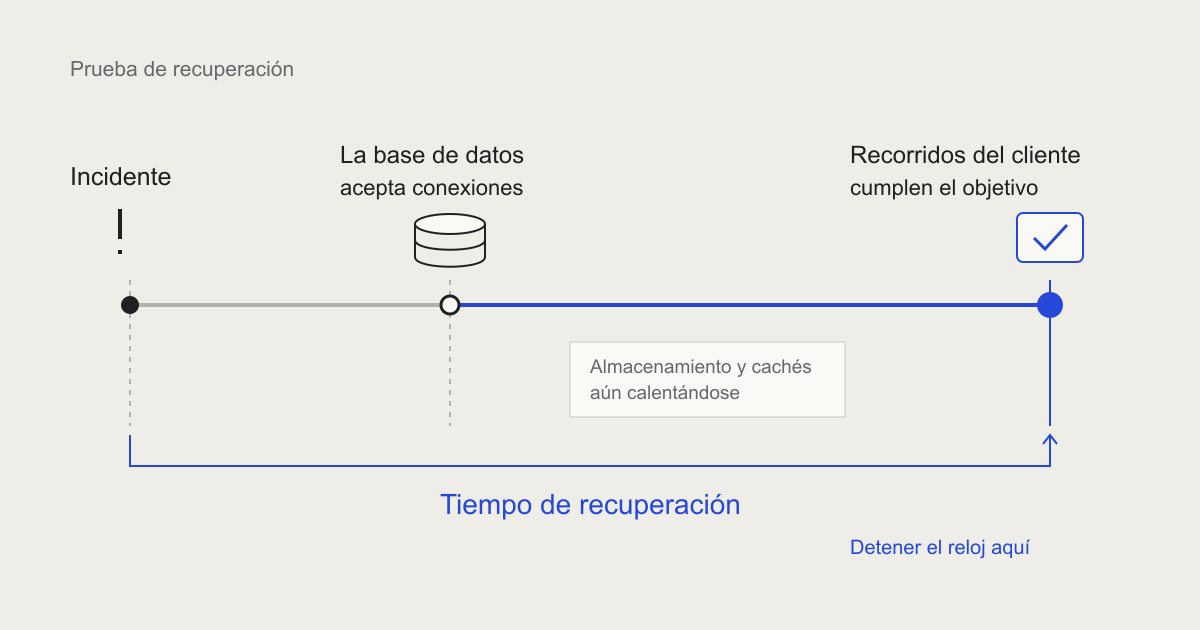
Un simulacro de restauración puede darse por bueno mientras el proceso de compra sigue agotando el tiempo de espera. Si la prueba termina cuando la base de datos acepta una conexión, nadie ha establecido cuándo pueden los clientes volver a usar el producto. Ese intervalo debe formar parte del plan de recuperación.
Un artículo técnico de AWS del 14 de octubre describe instancias RDS para PostgreSQL disponibles mientras los datos de la instantánea siguen cargándose en las primeras lecturas. El plan de recuperación debe incluir la experiencia del cliente durante ese intervalo. ¿Qué entiende el equipo por «recuperado»?
Elegir qué operaciones deben reanudarse
Empieza con una conversación breve entre quienes operan el servicio y quienes responden ante los clientes. ¿Qué trabajo debe volver primero? Una tienda puede mostrar un catálogo en caché y seguir sin registrar pedidos. Una herramienta empresarial puede abrir su panel, pero fallar al guardar una aprobación. Elige unos pocos recorridos completos, incluidas sus escrituras, en lugar de una lista de componentes que funcionan.
Asigna una condición de aceptación a cada recorrido: resultado esperado, tiempo de respuesta aceptable y nivel de tráfico. Separa el RTO, el plazo objetivo para restablecer el servicio, del RPO, la pérdida de datos aceptable expresada en tiempo. Un proceso de compra rápido sobre una base demasiado antigua puede cumplir el primer objetivo y fallar en el segundo. Ambos necesitan una persona responsable que pueda aceptar sus consecuencias para el negocio.
Partir del estado que dejaría un incidente
Para el ejercicio, restaura una copia reciente y representativa en un entorno aislado. Protege los datos como en producción y desactiva pagos reales, mensajes y tareas que actúen sobre sistemas externos. Anota el punto de recuperación de la copia y cuándo termina cada paso. Evita preparar discretamente una base ya precalentada la noche anterior: eliminarías parte del trabajo que el ejercicio pretende medir.
Una base de prueba diminuta puede ocultar el tiempo necesario para mover datos y cargar los que utiliza la aplicación. Usa un tamaño y una distribución representativos, con enmascaramiento o datos sintéticos cuando corresponda. Registra las diferencias que no puedas reproducir, como las cuotas o la capacidad de red. El resultado sirve como evidencia para esas condiciones; no es un tiempo de recuperación universal.
Probar la aplicación antes de declarar la recuperación
Reconecta la aplicación siguiendo el procedimiento documentado y ejecuta los recorridos acordados. Comprueba los permisos de las cuentas, los secretos, los pools de conexiones y los procesos en segundo plano que usan esos recorridos. Envía un pedido de prueba y vuelve a encontrarlo. Guarda una aprobación y consulta su registro de auditoría. Una comprobación de estado de la base de datos no responde a esas preguntas.
Aumenta una carga controlada y observa los tiempos de respuesta, los errores y el crecimiento de las colas. Un sistema restaurado puede atender una petición y empezar a acumular retraso cuando vuelven los clientes. Mantén el cronómetro en marcha hasta que soporte de forma estable la carga acordada. Si una parte del producto sigue sin estar disponible, déjalo claro para que soporte pueda explicar qué ha vuelto y qué queda pendiente.
Revisa también las operaciones alrededor del punto de recuperación. Un proveedor de pagos puede haber aceptado un pago que la base restaurada ya no conoce. Reintentar todo puede provocar un segundo efecto externo. El ejercicio debe establecer qué registros hay que conciliar, cómo se evitan los duplicados y quién decide si se puede reanudar el procesamiento.
Precalentar primero los recorridos importantes
Cuando las lecturas en frío sean el cuello de botella, prueba un precalentamiento deliberado antes de admitir el tráfico normal. Empieza por las tablas y los índices de los recorridos prioritarios. El módulo pg_prewarm de PostgreSQL puede cargar datos en las cachés del sistema operativo o de la base de datos. Su documentación también explica que esos bloques pueden expulsarse: cargar más datos de los que caben en la caché no los mantiene todos en memoria.
Por tanto, el precalentamiento depende de la carga de trabajo. Leer todas las tablas puede retrasar las operaciones prioritarias y consumir la misma capacidad de entrada y salida que necesita la aplicación. Compara un precalentamiento selectivo, un retorno gradual del tráfico y el procedimiento actual en las mismas condiciones. Decide según el tiempo hasta disponer de un servicio utilizable, el coste de recursos y la complejidad operativa. El benchmark de un proveedor no es tu compromiso de recuperación.
Convertir el objetivo incumplido en una decisión de presupuesto
Si el tiempo medido no cumple el objetivo del negocio, identifica el paso lento antes de comprar una segunda región o una base más potente. Encontrar la copia correcta, obtener acceso, restaurar el almacenamiento, precalentar los datos y conciliar los registros requieren soluciones distintas. Si el retraso está en los accesos, automatizar una aprobación manual puede ayudar más que aumentar la capacidad de entrada y salida.
Un producto pequeño puede aceptar razonablemente una interrupción más larga y mantener un procedimiento sencillo. Un servicio con transacciones urgentes puede necesitar un sistema de reserva mantenido, una conmutación ensayada o un modo degradado más limitado. Esas opciones añaden costes recurrentes y más posibilidades de operar mal el sistema. Compara ese coste con las consecuencias de una interrupción y con la capacidad del equipo para mantener la solución.
Dejar evidencia que pueda usar la siguiente persona
El resultado útil es un procedimiento breve con la copia probada, las condiciones del entorno, los accesos necesarios, las comprobaciones de los recorridos y los tiempos medidos. Designa a quien puede declarar la recuperación y a quien informa a los clientes. Incluye el trabajo de conciliación pendiente después de que vuelva el servicio.
Repite el ejercicio tras un cambio importante en el volumen de datos, el almacenamiento, las dependencias o el procedimiento. Conserva el resultado anterior para ver si la recuperación se está ralentizando. La siguiente conversación podrá empezar por una diferencia concreta y una solución propuesta, en lugar de otra garantía de que las copias de seguridad están activadas.