Analyse CTO par Ilya Ilin
Un script qui prépare un rapport à partir de données fictives et un correctif qui modifie la facturation des clients méritent des contrôles différents. Un outil d’IA peut produire les deux rapidement. Pour décider de la revue nécessaire, il faut partir des données, des permissions et des comportements que le changement peut affecter.
C’est la question utile soulevée par le post de Boris Cherny sur les prototypes jetables : jusqu’où une erreur peut-elle se propager ? Un prototype disposant d’identifiants de production peut toucher de vrais clients. Son nom ne réduit pas ce risque.
Pour un fondateur ou un responsable technique dans une grande entreprise, un résultat utile est une courte règle de mise en production que l’équipe peut appliquer au prochain changement. Voici comment je la structurerais.
Décrire l’échec que l’on veut éviter
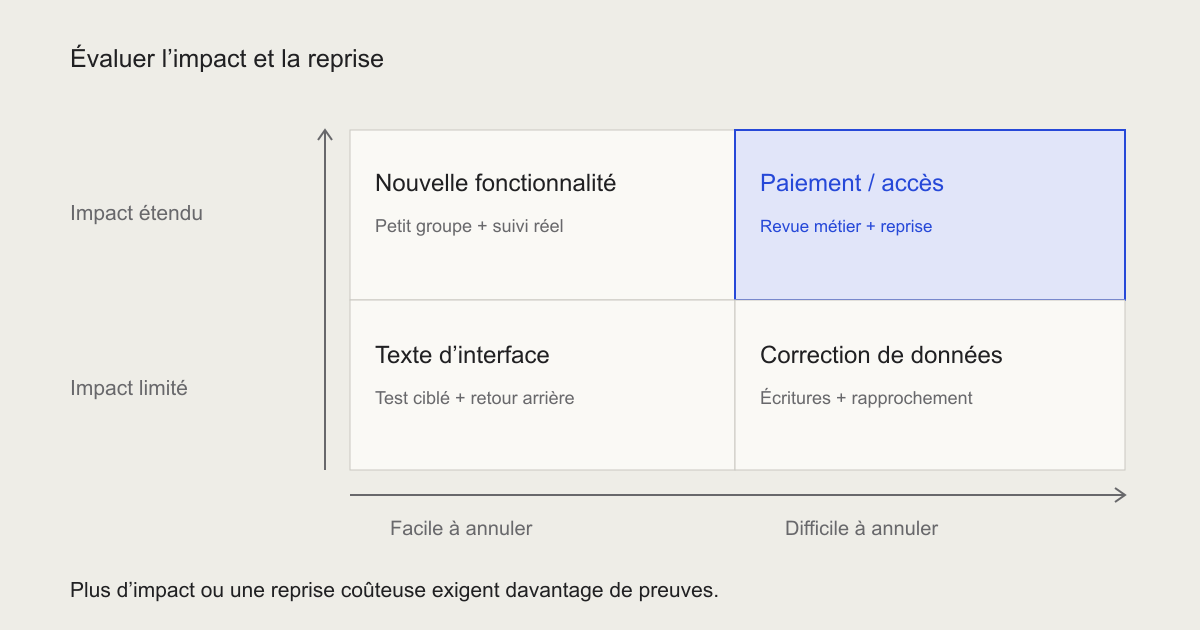
Avant de lire les modifications du code, demandez ce qui se passe si elles sont incorrectes. Une personne pourrait-elle recevoir une facture erronée, voir les données d’un autre compte ou perdre son travail ? L’équipe peut-elle rétablir le comportement précédent sans réparer les données enregistrées ? Ces réponses aident à déterminer les preuves nécessaires avant la mise en production.
Commencez par trois catégories de travail. Utilisez-les pour déterminer les questions auxquelles la personne chargée de la revue doit répondre. Une modification des permissions en une seule ligne peut relever de la catégorie la plus exigeante. Une expérience plus importante peut rester peu risquée si son environnement et ses données sont isolés.
- Expérience isolée : données fictives ou jetables, aucun identifiant de production et aucune écriture dans des systèmes partagés. Un résultat incorrect peut être abandonné.
- Modification du produit : de vrais utilisateurs ou des dépendances peuvent être affectés. Désignez un responsable, testez le parcours important et définissez comment limiter le déploiement ou revenir en arrière.
- Opération sensible : argent, droits d’accès ou écritures difficiles à annuler. Ajoutez une revue par une personne qui connaît le domaine, des preuves couvrant les cas d’échec et un plan pour corriger tout état incohérent.
Délimiter le correctif pour pouvoir l’examiner
Supposons qu’un agent soit chargé de corriger le calcul d’une facture et qu’il réorganise aussi le module de facturation. La personne qui relit doit alors distinguer le changement de comportement voulu de la réorganisation du code. Séparer ces modifications facilite l’examen du calcul, l’identification d’une régression et le choix de ce qu’il faut annuler.
Le responsable humain doit pouvoir expliquer la décision importante sans répéter le résumé de l’agent. Quel comportement change pour le client ? Quelles hypothèses restent valables ? Qu’a-t-on volontairement laissé de côté ? Si les réponses nécessitent une nouvelle enquête approfondie, le correctif a besoin de limites plus claires ou d’une personne possédant les connaissances nécessaires. Produire davantage de code ne fera qu’allonger cette file d’attente.
Demander un test qui détecterait l’erreur
Pour un traitement de facturation, un test utile peut transmettre deux fois le même événement et vérifier le résultat enregistré. Il peut aussi interrompre le traitement après une écriture, puis relancer l’opération. Vérifier qu’une fonction a été appelée une seule fois apporte moins de preuves sur le risque de facturer deux fois un client. Le test doit observer la conséquence qui compte pour l’équipe.
Utilisez un test de bout en bout pour le parcours qui traverse la frontière modifiée : par exemple, un utilisateur aux droits limités qui ouvre la page du compte après un changement des permissions. Définissez explicitement le comportement attendu. Un agent peut écrire des tests parfaitement compatibles avec sa propre implémentation erronée. Une personne qui comprend le produit doit donc toujours choisir ce qui doit rester vrai.
Intégrer la règle au processus de livraison
Précisez quels changements exigent quels contrôles, qui les approuve et ce qui constitue une exception. Faites ensuite appliquer les éléments que le système de livraison peut imposer. Les revues et contrôles de statut obligatoires font partie des mécanismes disponibles sur les plateformes de dépôts ; la documentation de GitHub sur la protection des branches en donne un exemple concret. Un rappel dans les instructions d’un agent n’impose pas ces obligations.
Un contrôle de livraison est utile lorsqu’il examine la version candidate qui sera réellement exécutée. Testez le site généré ou le service empaqueté, conservez les résultats et livrez cette même révision. Si un contrôle est instable, identifiez la cause et corrigez-le. Le relancer jusqu’à obtenir un résultat positif fait dépendre la décision de livraison du hasard. La procédure d’exception doit nommer le responsable et les preuves manquantes.
Prévoir comment détecter et contenir un échec
Avant le déploiement, choisissez un signal qui ferait arrêter l’équipe. Pour une modification du paiement, il peut s’agir d’achats échoués ou de commandes dans un état incorrect. Un déploiement limité peut révéler un problème avant que tous les clients ne reçoivent le changement. Le guide SRE de Google décrit cette approche canary et l’évaluation nécessaire avant d’élargir le déploiement.
Soyez précis sur la reprise. Revenir à un ancien binaire peut rétablir le comportement précédent, sans réparer automatiquement un enregistrement déjà modifié ni retirer un message déjà envoyé. Une écriture sensible peut nécessiter un moyen d’arrêter les nouvelles opérations, d’identifier les enregistrements concernés et de les réconcilier. Ajoutez ce travail et son responsable au plan de mise en production avant d’approuver le changement.
Prévoir le travail après la génération du code
Une équipe peut produire des correctifs plus vite tout en passant davantage de temps à attendre une revue ou à réparer des livraisons. Examinez le délai entre la proposition d’un changement et sa mise en production vérifiée, l’ancienneté des demandes de revue et le travail nécessaire après le déploiement. Ces mesures aident un fondateur à déterminer si le prochain investissement doit porter sur l’implémentation, une meilleure délimitation des tâches ou des vérifications plus solides.
Gardez des règles proportionnées. Une petite équipe peut commencer par une page indiquant un responsable, l’échec possible, les preuves et le plan de reprise. Une grande entreprise dispose peut-être déjà de responsables métier et de contrôles d’approbation auxquels se rattacher. Dans les deux cas, laissez de la liberté aux expériences à faible impact et réservez la revue approfondie aux changements dont les conséquences le justifient.