Análisis CTO por Ilya Ilin
Un script que prepara un informe con datos sintéticos y un parche que modifica la facturación de los clientes merecen comprobaciones distintas. Una herramienta de IA puede producir ambos rápidamente. La decisión sobre la revisión empieza por los datos, los permisos y el comportamiento que el cambio puede afectar.
Esa es la pregunta útil que plantea el post de Boris Cherny sobre los prototipos desechables: ¿hasta dónde puede llegar un error? Un prototipo con credenciales de producción puede afectar a clientes reales. Su nombre no reduce ese riesgo.
Para un fundador o un responsable de ingeniería de una gran empresa, un resultado útil es una política breve de publicación que el equipo pueda aplicar al siguiente cambio. Así es como la estructuraría.
Describir el fallo que se quiere evitar
Antes de revisar las diferencias del código, pregunta qué ocurre si el cambio es incorrecto. ¿Podría alguien recibir una factura equivocada, ver los datos de otra cuenta o perder trabajo? ¿Puede el equipo recuperar el comportamiento anterior sin reparar los datos guardados? Esas respuestas ayudan a determinar qué pruebas hacen falta antes de publicar.
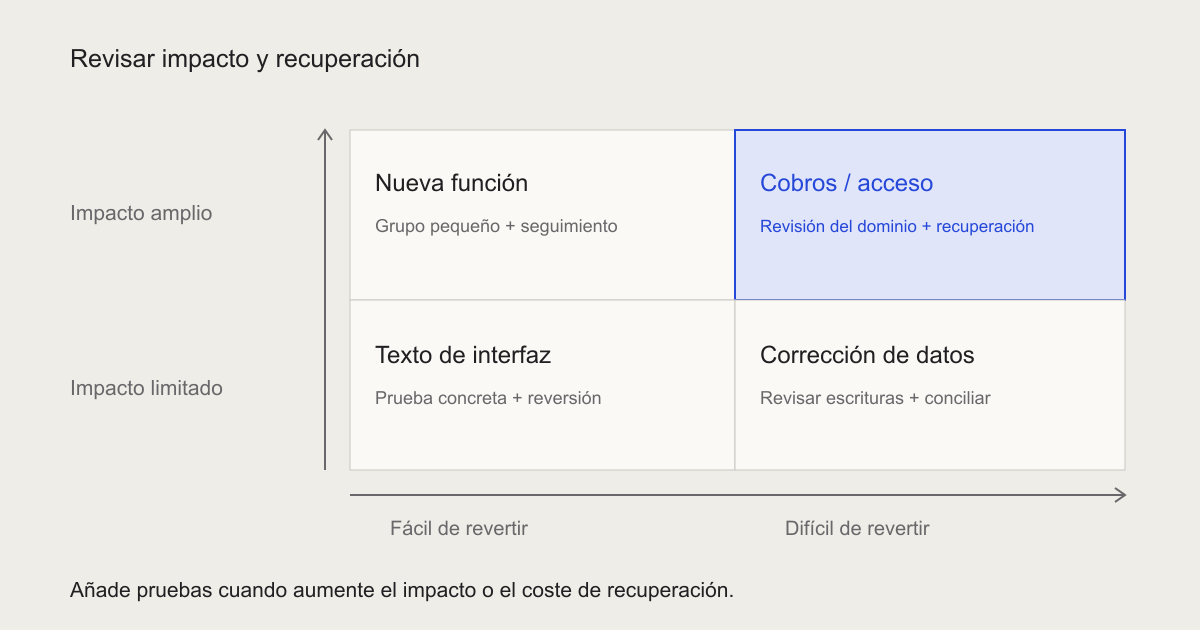
Empieza con tres categorías de trabajo. Úsalas para decidir qué preguntas debe responder quien revisa el cambio. Una modificación de permisos de una sola línea puede pertenecer a la categoría más exigente. Un experimento de mayor tamaño puede seguir siendo de bajo riesgo si tanto su entorno como sus datos están aislados.
- Experimento aislado: datos sintéticos o desechables, sin credenciales de producción ni escrituras en sistemas compartidos. Un resultado incorrecto se puede descartar.
- Cambio del producto: puede afectar a usuarios reales o a dependencias. Asigna un responsable, prueba el recorrido importante y define cómo limitar el despliegue o volver atrás.
- Operación sensible: implica dinero, derechos de acceso o escrituras difíciles de deshacer. Añade la revisión de alguien que conozca el dominio, pruebas de los casos de fallo y un plan para corregir cualquier estado incoherente.
Limitar el parche para poder revisarlo
Supongamos que se pide a un agente que corrija el cálculo de una factura y que también reorganiza el módulo de facturación. Quien revisa tiene que separar el cambio de comportamiento buscado de la reorganización del código. Dividir esas modificaciones facilita examinar el cálculo, localizar una regresión y decidir qué deshacer.
El responsable humano debe poder explicar la decisión importante sin repetir el resumen del agente. ¿Qué comportamiento cambia para el cliente? ¿Qué supuestos siguen vigentes? ¿Qué se ha dejado fuera deliberadamente? Si responder exige otra investigación extensa, el parche necesita límites más claros o una persona con los conocimientos adecuados. Generar más código solo añadirá trabajo a esa cola.
Pedir una prueba que detectaría el error
Para un proceso de facturación, una prueba útil puede entregar dos veces el mismo evento y comprobar el resultado guardado. También puede interrumpir el proceso después de una escritura y volver a intentarlo. Comprobar que una función se llamó una sola vez aporta menos evidencia sobre la posibilidad de cobrar dos veces a un cliente. La prueba debe observar la consecuencia que importa al equipo.
Utiliza una prueba de extremo a extremo para el recorrido que atraviesa el límite modificado: por ejemplo, un usuario con permisos restringidos que abre la página de la cuenta después de cambiar los permisos. Define explícitamente el comportamiento esperado. Un agente puede escribir pruebas que encajen perfectamente con su propia implementación equivocada, por lo que alguien que entienda el producto sigue teniendo que decidir qué debe continuar siendo cierto.
Incorporar la regla al proceso de publicación
Deja por escrito qué cambios necesitan qué comprobaciones, quién los aprueba y qué se considera una excepción. Después, haz que el sistema de entrega imponga los requisitos que pueda controlar. Las revisiones y comprobaciones de estado obligatorias son mecanismos disponibles en las plataformas de repositorios; la documentación de GitHub sobre ramas protegidas ofrece un ejemplo concreto. Un recordatorio en las instrucciones de un agente no impone obligaciones equivalentes.
Una comprobación de publicación resulta útil cuando examina la versión candidata que realmente se va a ejecutar. Prueba el sitio generado o el servicio empaquetado, conserva los resultados y publica esa misma revisión. Si una comprobación es inestable, identifica la causa y repárala. Repetirla hasta que salga un resultado positivo hace que la decisión de publicar dependa del azar. El proceso de excepción debe identificar al responsable y las pruebas que faltan.
Decidir cómo detectar y contener un fallo
Antes del despliegue, elige una señal que haría que el equipo se detuviese. En un cambio del proceso de compra, podría incluir compras fallidas o pedidos con un estado incorrecto. Un despliegue limitado puede descubrir un problema antes de que el cambio llegue a todos los clientes. La guía SRE de Google describe este enfoque canary y la evaluación necesaria antes de ampliarlo.
Concreta la recuperación. Volver a un binario anterior puede restablecer su comportamiento, pero no repara automáticamente un registro ya modificado ni retira un mensaje que ya se ha enviado. Una escritura sensible puede necesitar un mecanismo para detener nuevas operaciones, identificar los registros afectados y corregir sus inconsistencias. Incluye ese trabajo y su responsable en el plan de publicación antes de aprobar el cambio.
Presupuestar el trabajo posterior a generar código
Un equipo puede generar parches más deprisa mientras dedica más tiempo a esperar revisiones o reparar versiones publicadas. Observa el tiempo desde que se propone un cambio hasta una publicación verificada, la antigüedad de la cola de revisión y el trabajo necesario después del despliegue. Estas medidas ayudan a un fundador a decidir si la siguiente inversión corresponde a la implementación, a delimitar mejor las tareas o a mejorar la verificación.
Mantén una política proporcionada. Un equipo pequeño puede empezar con una página que indique un responsable, el posible fallo, las pruebas y el plan de recuperación. Una gran empresa quizá ya tenga responsables de dominio y controles de aprobación con los que conectar el proceso. En ambos casos, deja margen a los experimentos de bajo impacto y reserva la revisión más profunda para los cambios cuyas consecuencias la justifiquen.